HiRoLabブログ

HiRoのゆるふわIT備忘録

Entra IDのユーザでvSphere Clientにログインする手順纏め

はじめに

この記事はvSphere ClientのログインをEntra IDのユーザを利用してログインする手順となります。

検証環境

検証環境は以下です。

・Azure (個人アカウント)

・vCenter Server 8.0.3 build-25413364 (Home LAB)

検証の流れ

手順の流れは以下です。

  1. AzureのEntra IDでユーザ作成
  2. Azure のEntra IDでアプリの登録
  3. 登録されたアプリでクライアントシークレットの追加
  4. vCenterでEntra IDの設定
  5. AzureでリダイレクトURIを設定
  6. Entra IDのユーザをvCenterへ登録
  7. vCenterでグローバル権限追加
  8. Entra IDのユーザでログイン
AzureのEntra IDでユーザ作成
  1. Azureにログインします。
  2. Microsoft Entra IDにあるユーザを選択します。
  3. 新しいユーザをクリックします。
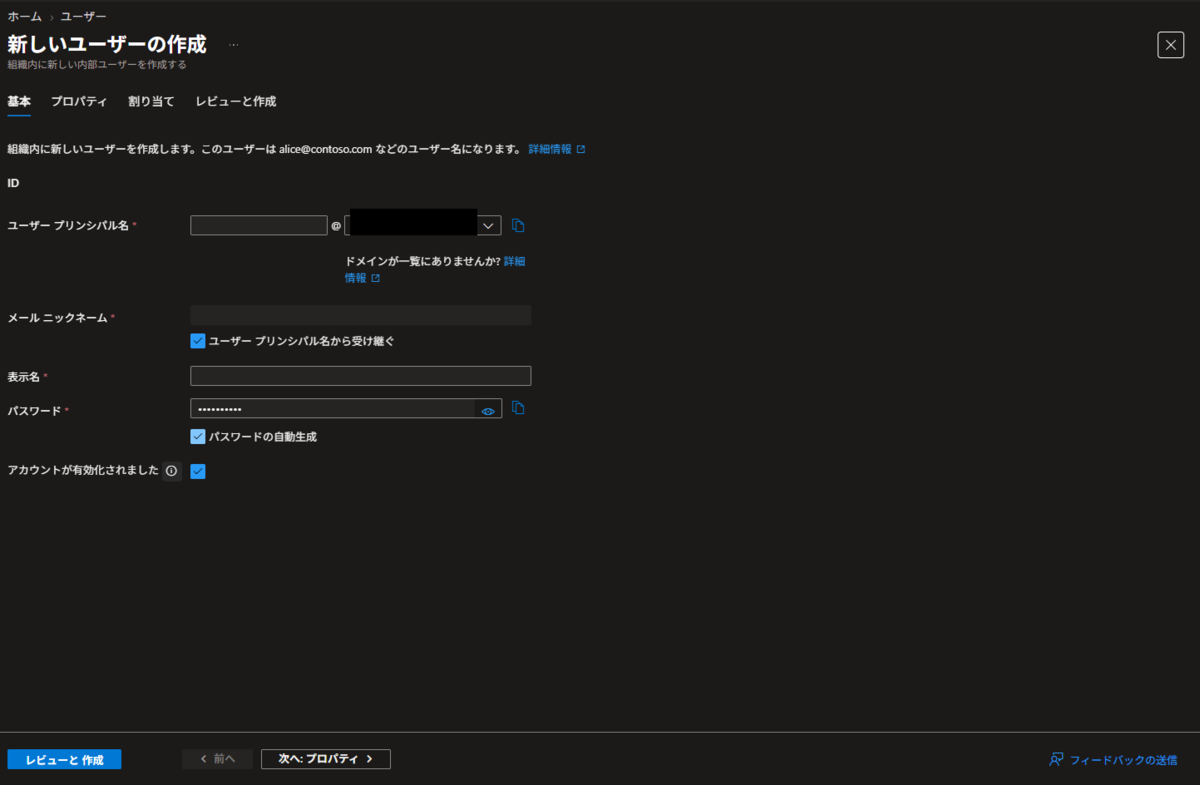
  4. 下図のようにユーザプリンシパル名を入力して、ユーザを作成します。
AzureのEntra IDでアプリの登録

ここではEntra IDにアプリの登録を行い、登録されたアプリのアプリケーション(クライアント)IDとOpenID Connect メタデータドキュメントを確認します。

  1. Microsoft Entra IDにあるアプリの登録をクリックします。

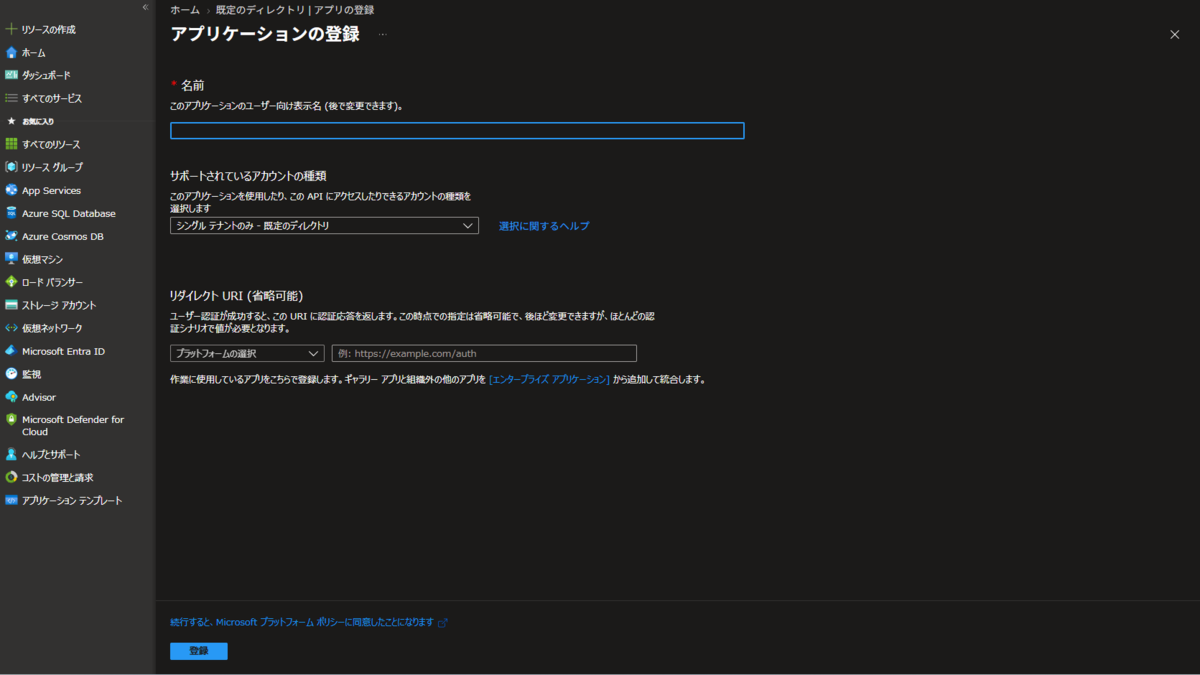
  2. 新規登録のボタンをクリックすることで下図のようになる為、登録する任意のアプリ名を入力します。

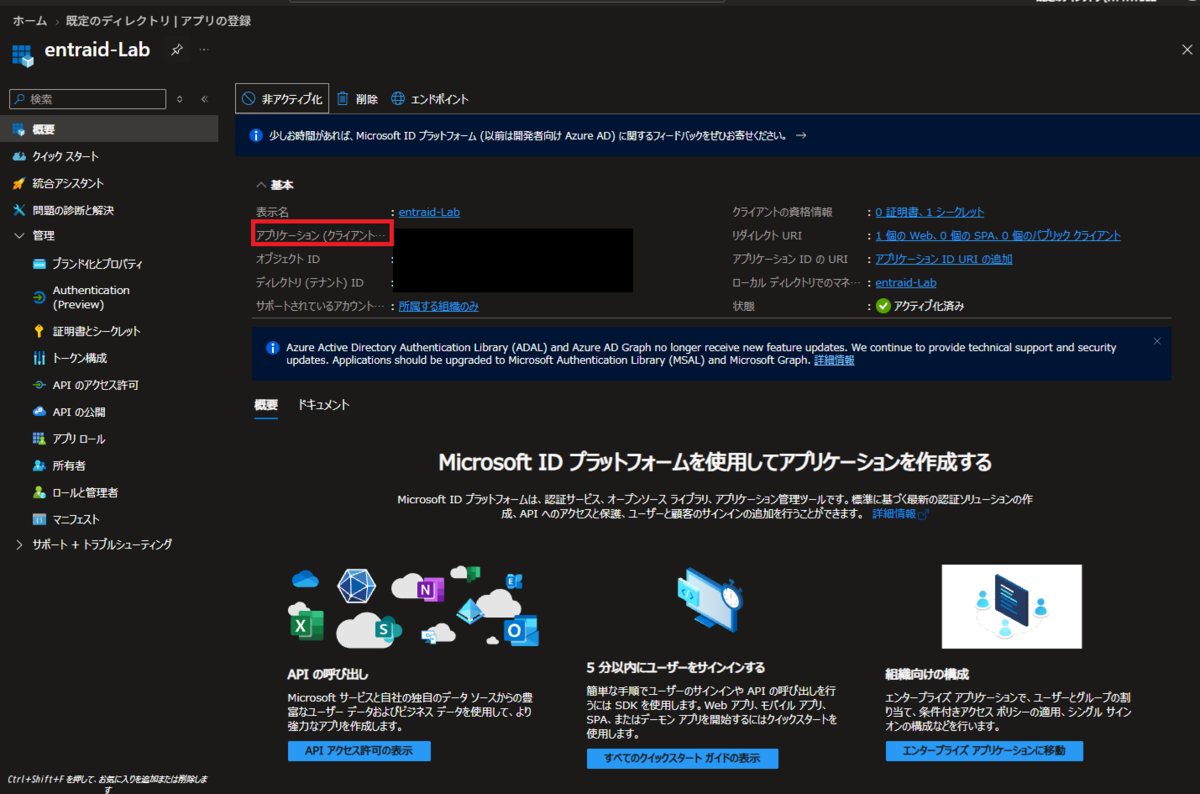
  3. vCenterのEntra IDで利用するため、アプリケーション(クライアント)IDをクリップボードにコピーして控えます。
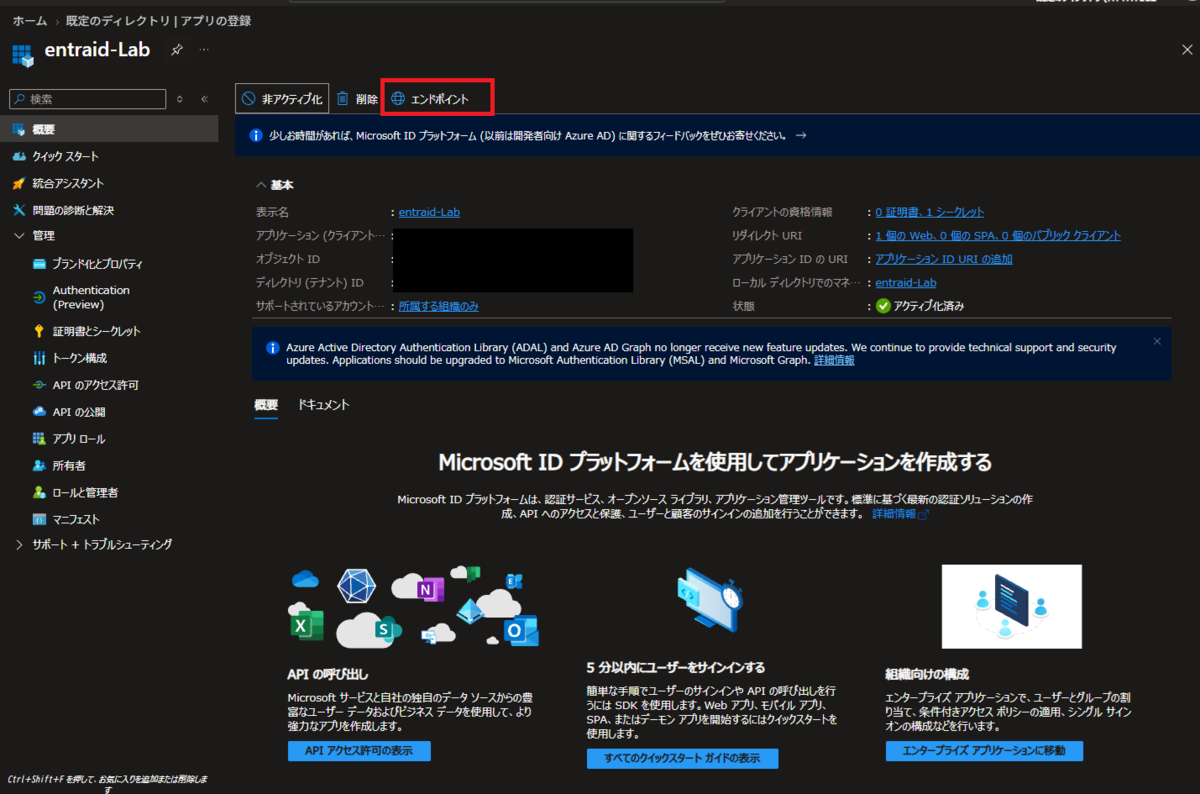
  4. 続いてエンドポイントをクリックします。
  5. 表示されたOpenID Connect メタデータ ドキュメントをコピーして控えます。
登録されたアプリでクライアントシークレットの追加

ここでは以降のvCenterのEntra IDの設定で必要なクライアントシークレットの作成と生成された値をコピーして控えます。

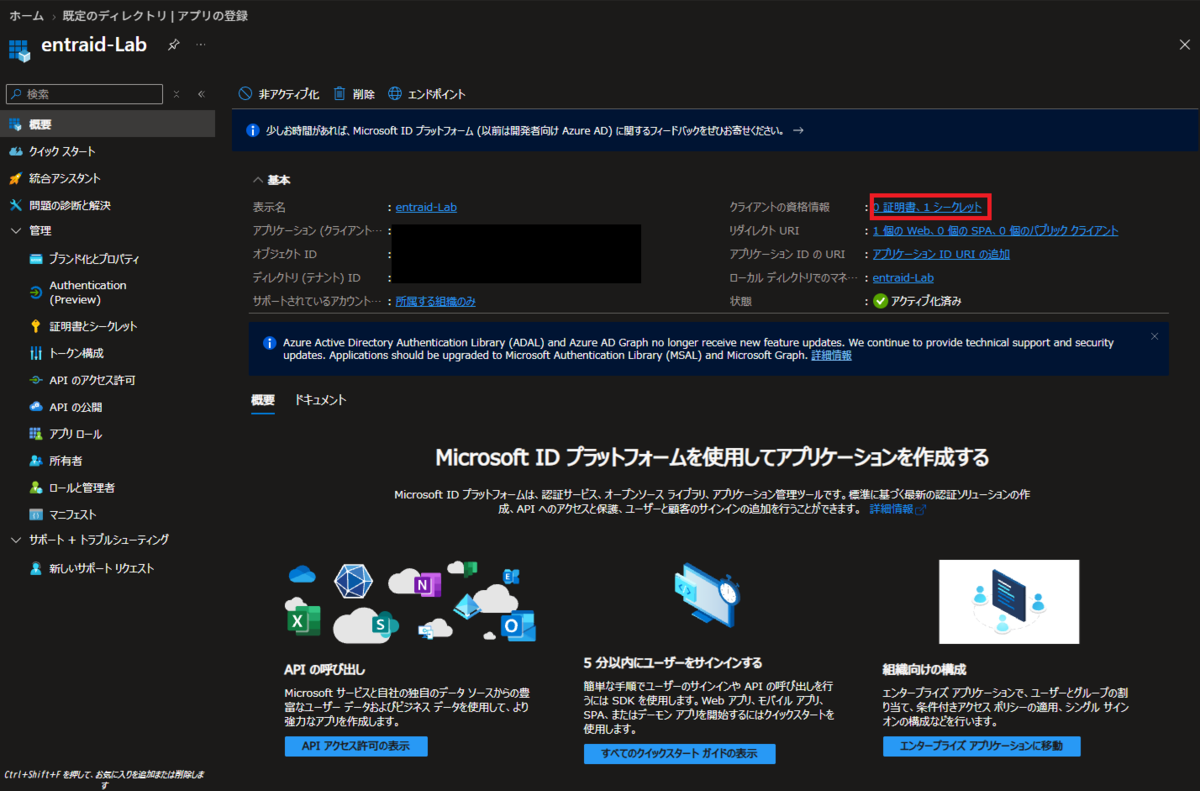
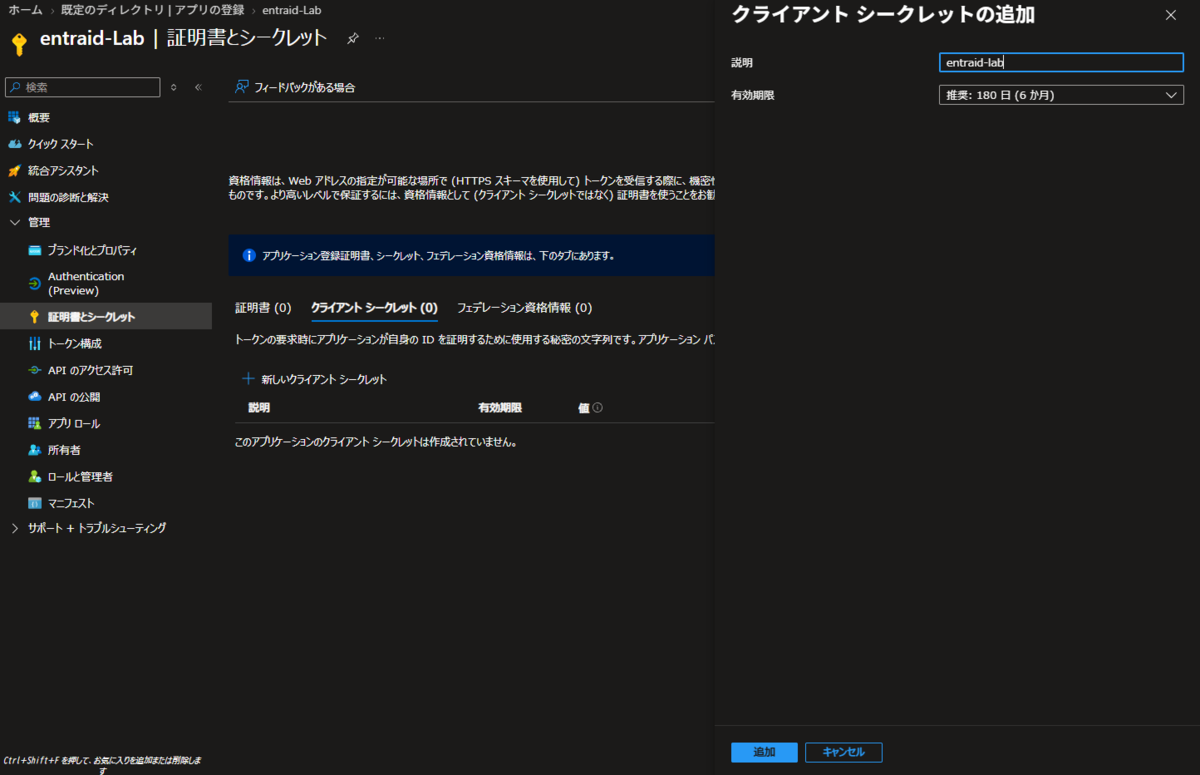
  1. 作成したアプリケーションを選択 して クライアントの資格情報にあるリンクをクリックします。
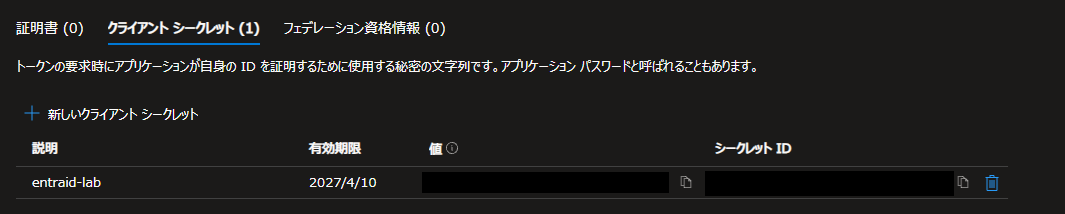
  2. クライアントシークレットの追加で任意の名前を入力して追加します。
    3.以降の手順でクライアントシークレットの値を利用する為、コピーして控えます。
vCenterでEntra IDの設定
  1. vSpher Clientにログインします。
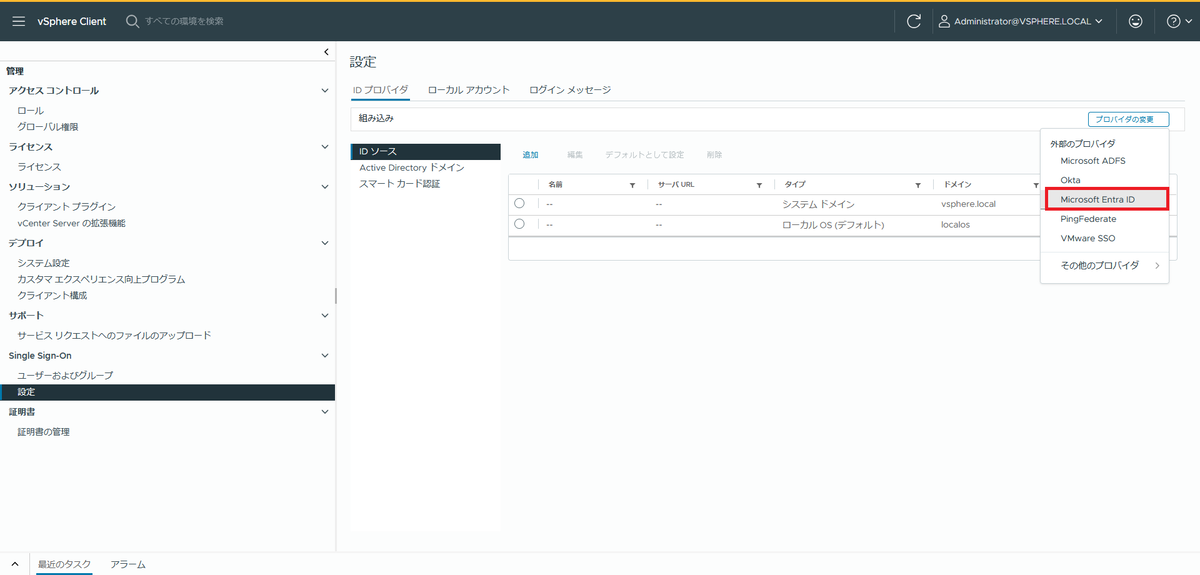
  2. ハンバーガーマークよりシングルサインオンの設定に進みます。

  3. 下図のようにIDソースよりプロバイダの変更でEntra IDを選択します。

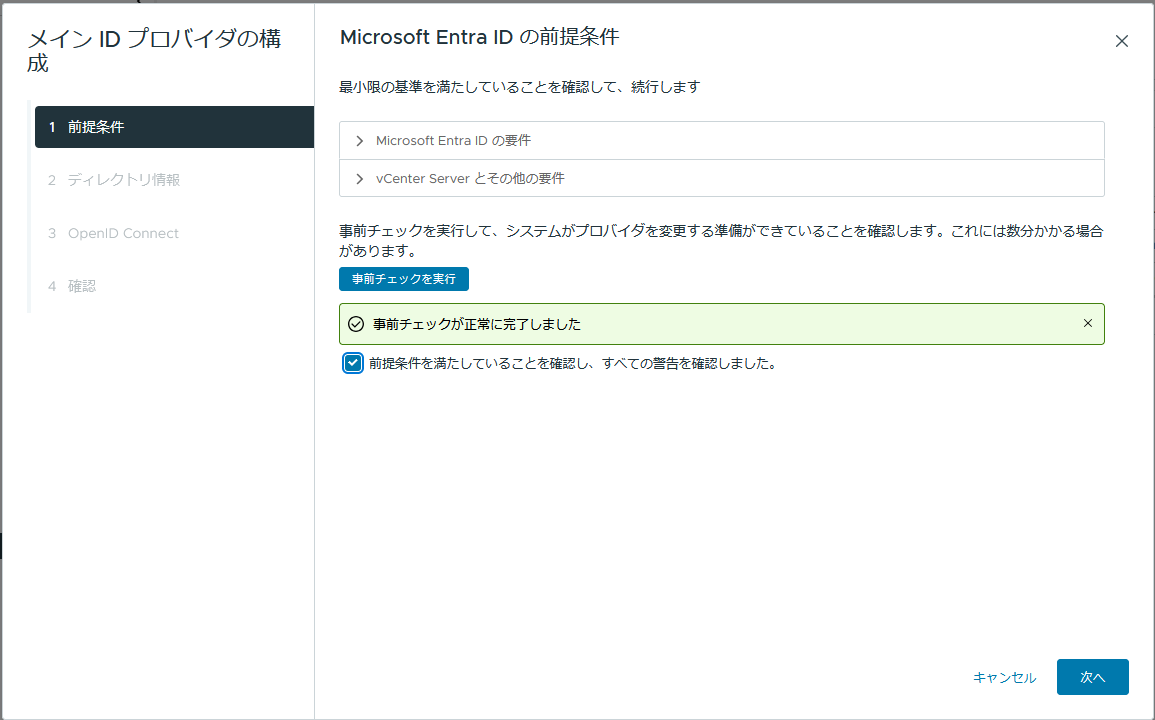
  4. 事前チェックを実施して次へ。
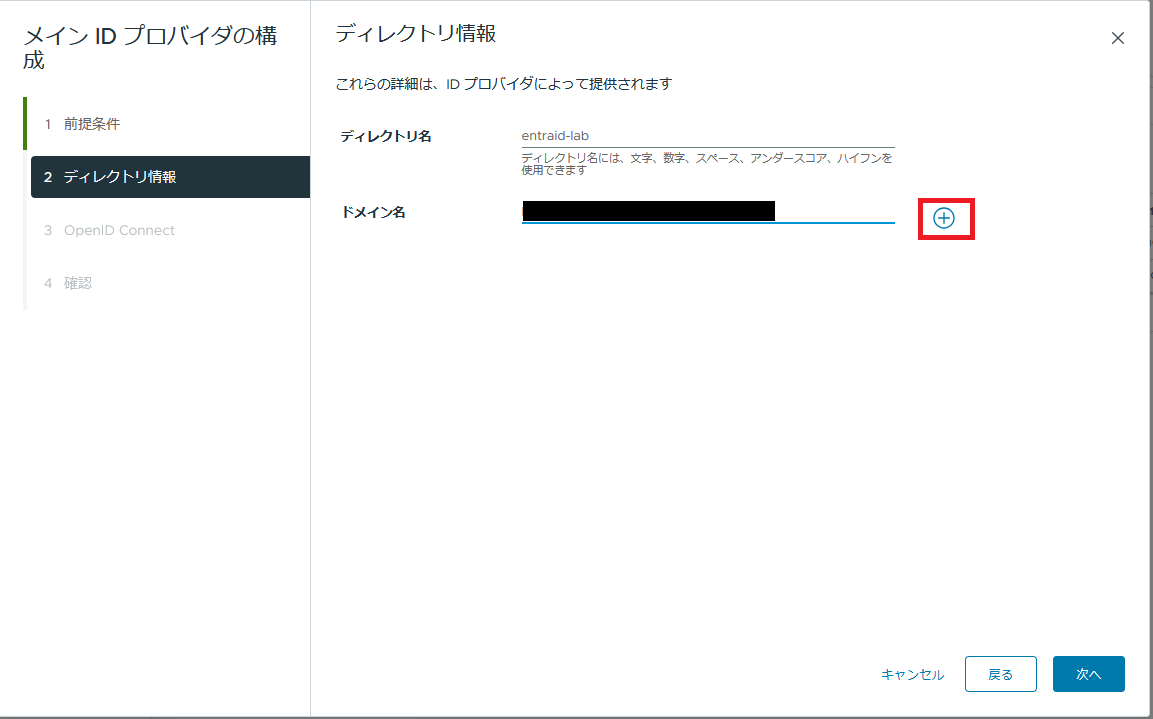
  5. 任意のディレクトリ名を入力して、ドメイン名はユーザプリンシパル名の@以降にあるドメインを入力します。  
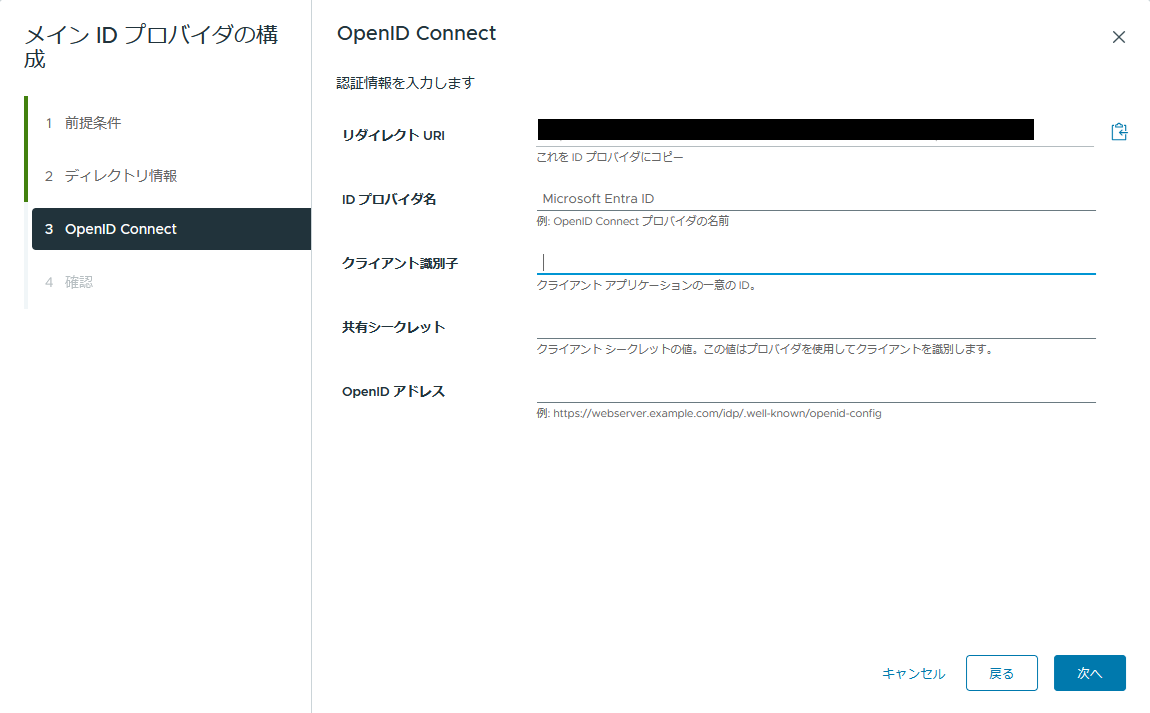
  6. OpenID Connectの画面で事前に控えた、アプリケーション(クライアント)IDを"クライアント識別子"に、クライアントシークレットの値を "共有シークレット"に、OpenID Connect メタデータ ドキュメントを "OpenID アドレス"に入力します。  
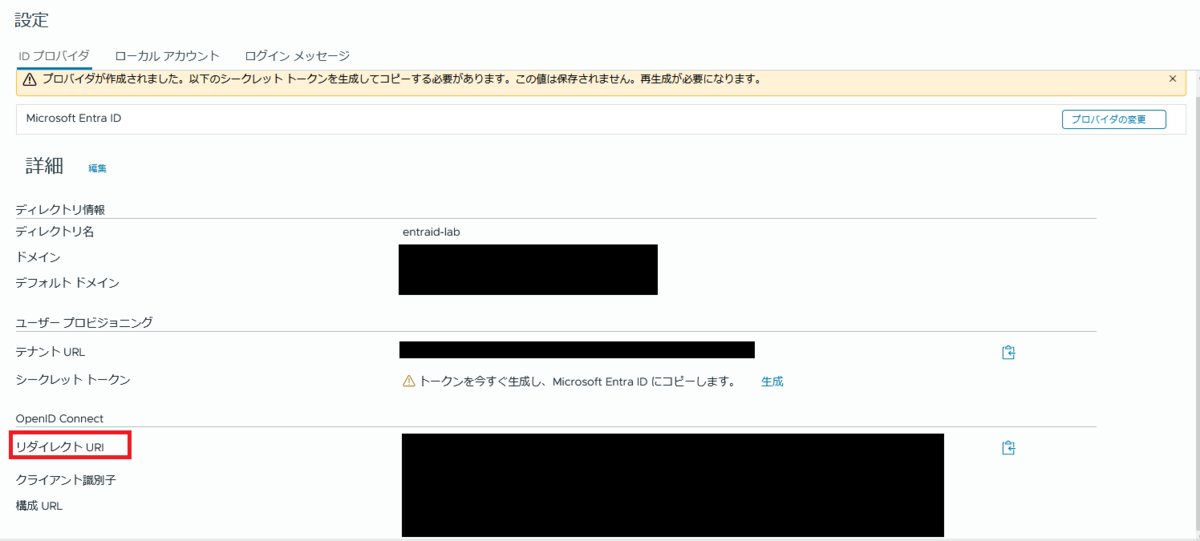
  7. Entra IDの設定が完了すると下図のようになり、リダイレクトURLをコピーして控えます。  
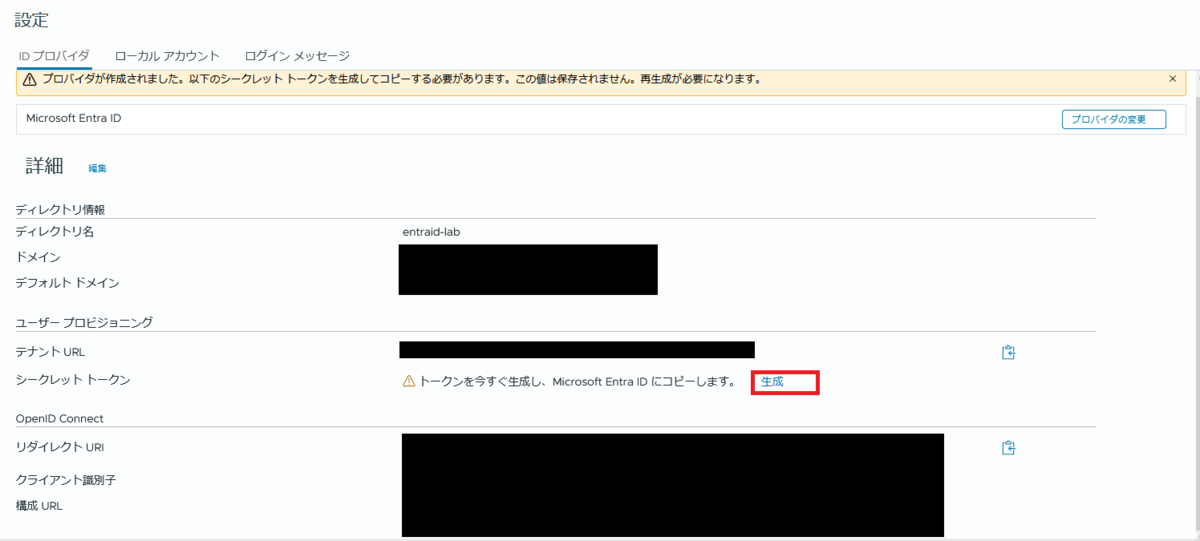
  8. 以降の手順でシークレットトークンは生成が必要となる為、シークレットトークン生成しコピーして控えます。  
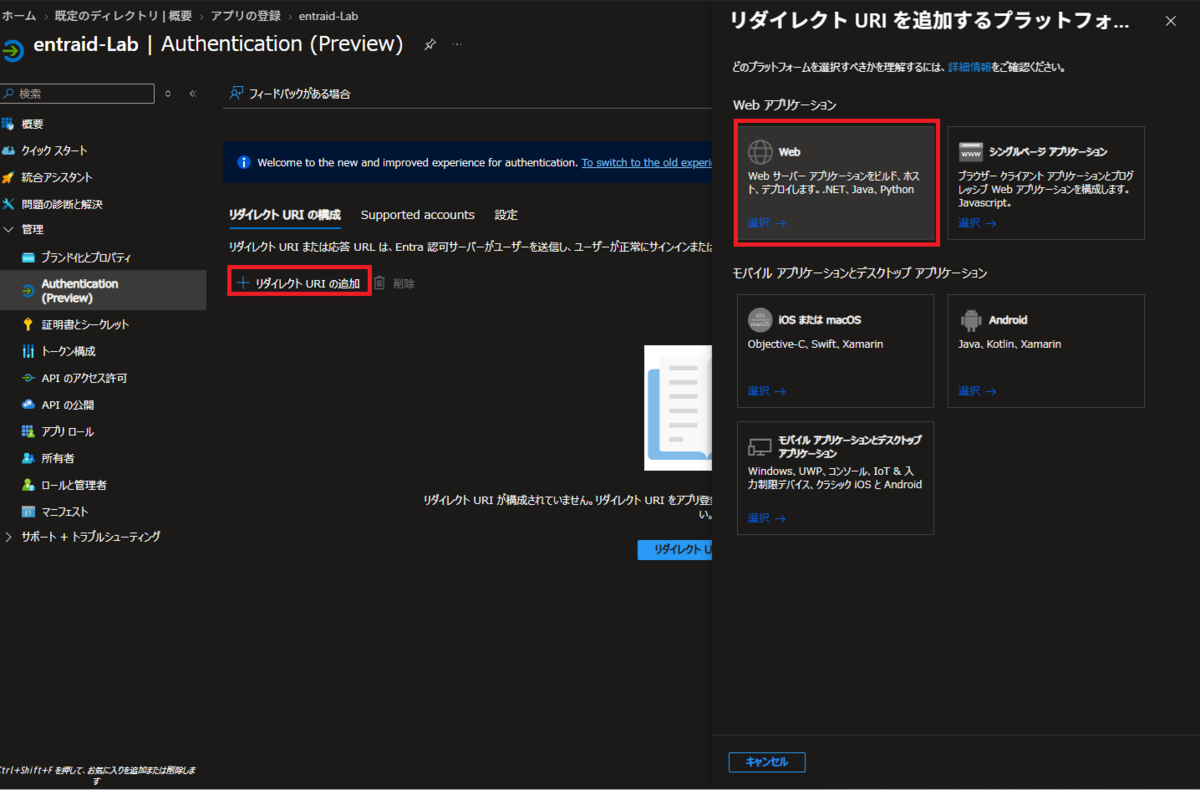
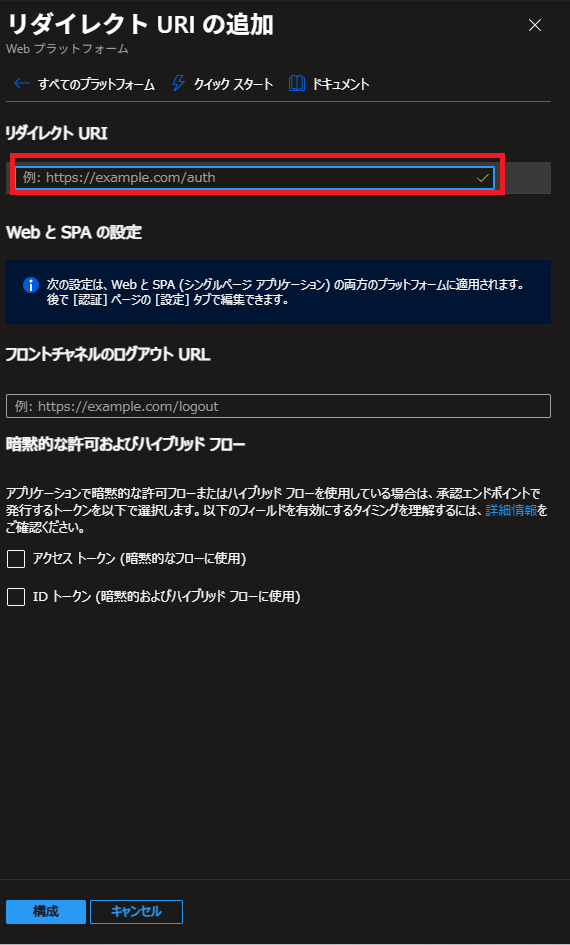
AzureでリダイレクトURIを設定
  1. 登録したアプリの画面でリダイレクトURIを選びます。
  2. vCenterでEntra IDの設定でコピーして控えたダイレクトURIを貼り付けます。
Entra IDのユーザをvCenterへ登録

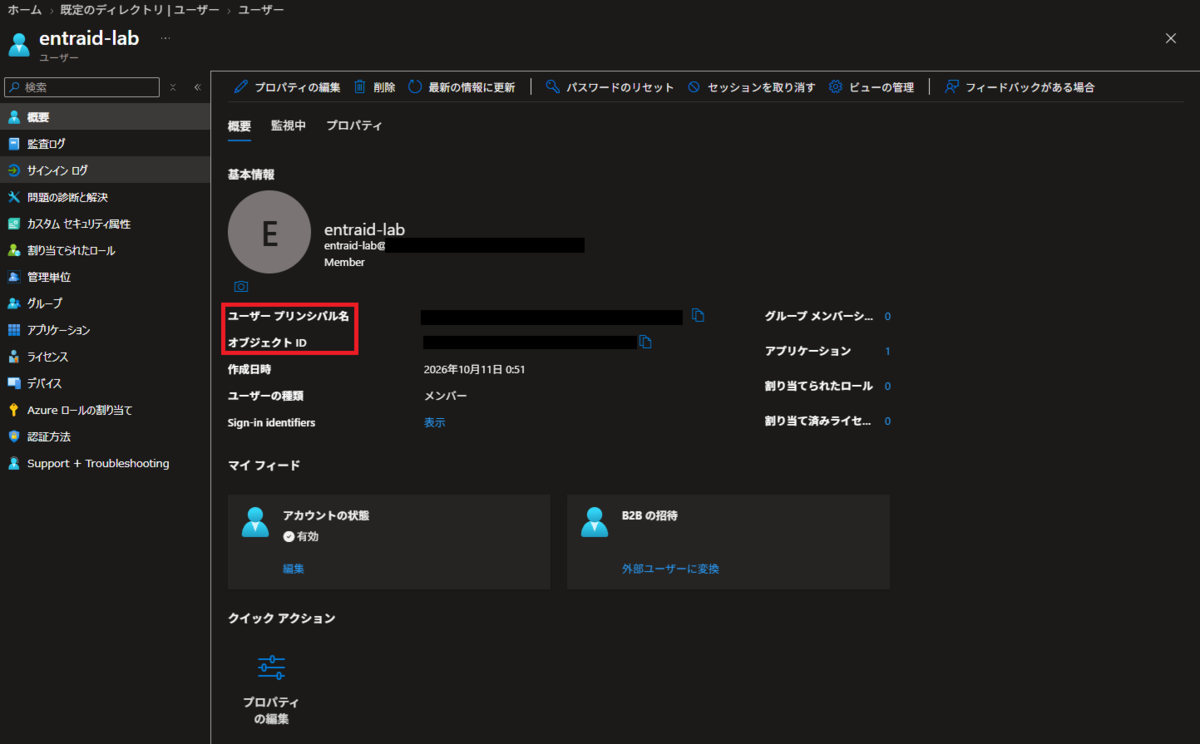
Entra IDのユーザを識別するためにvCenterへ登録を行います。

  1. 以下のユーザプリンシパル名とオブジェクトIDを控えます。
  2. vCenterに接続可能な任意のLinuxにログインし、以下コマンドでSCIMのトークンを設定します。
    *コマンド実行の際に、生成したシークレットトークンの入力が求められます。
SCIM_BASE='<vCenterのEntra IDの設定で得られたテナントURL>'

read -rsp 'vCenter SCIM token: ' SCIM_TOKEN
echo

curl --insecure --silent --show-error --include \
  --resolve '<vCenterのFQSDN>:443:<vCenterのIPアドレス>' \
  -H "Authorization: Bearer ${SCIM_TOKEN}" \
  -H 'Accept: application/scim+json' \
  "${SCIM_BASE%/}/Users?count=10"
  1. vCenterのFQDN、vCenterのIPアドレス、Entra IDのユーザ名、控えたオブジェクトID、ユーザプリンシパル名にあるドメインに書き換え、以下を実行してユーザを登録します。
    *コマンド実行の際に、生成したシークレットトークンの入力が求められます。
curl --insecure --silent --show-error --include \
  --resolve '<vCenterのFQSDN>:443:<vCenterのIPアドレス>' \
  -X POST \
  -H "Authorization: Bearer ${SCIM_TOKEN}" \
  -H 'Content-Type: application/scim+json' \
  -H 'Accept: application/scim+json' \
  --data-binary @- \
  "${SCIM_BASE%/}/Users" <<'JSON'
{
  "schemas": [
    "urn:ietf:params:scim:schemas:core:2.0:User",
    "urn:ietf:params:scim:schemas:extension:ws1b:2.0:User"
  ],
  "userName": "<AzureのEntra IDのユーザ名>",
  "externalId": "<オブジェクトID>",
  "active": true,
  "displayName": "vCenter Lab User",
  "name": {
    "givenName": "Lab",
    "familyName": "User"
  },
  "urn:ietf:params:scim:schemas:extension:ws1b:2.0:User": {
    "domain": "<ユーザプリンシパル名にあるドメイン>"
  }
}
JSON
vCenterでグローバル権限追加

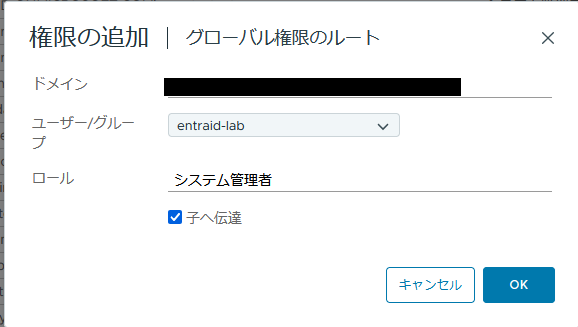
最後の設定としてEntra IDのユーザに権限を追加する手順となります。

  1. vSphere Clientの管理よりグローバル権限を選択します。

  2. 下図のように権限の追加でEntra IDのユーザを選択します。

Entra IDでログイン

ここまででvCenterとAzureでEntra IDの設定は以上となります。

  1. SIGN IN WITH SSOよりログインします。
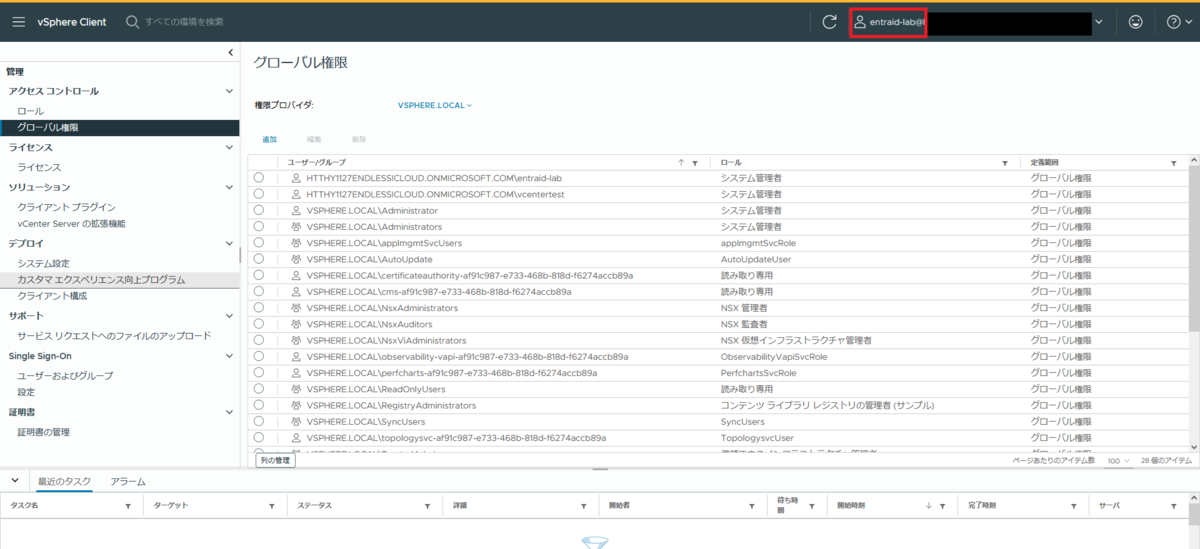
  2. ログインユーザがEntra IDのユーザであることを確認します。

*初回ログインの場合、手順1の後、パスワードの再設定が求められる為、指示に従い設定します。

さいごに

設定内容が多いため、自動化するようなツールを次は作っていきたい。

VMDKのCIDチェックツールの紹介

目次

はじめに

仮想マシンのVMDKファイルに含まれているCID、parentCIDの紐づけが正常であるかをチェックする為の可視化ツールを考えました。

この考えに至った背景は、以下KBにあるようにCIDの不一致による問題が生じることがあります。

"The parent virtual disk has been modified since the child was created" error

VMDKファイルが多くなると、CIDのチェックが大変です。
そこで、可視化、不一致があれば警告するツールを作ることで判断材料としていただきたく思います。

ツール実行環境

os : Fedora 42

言語:
- D3.js
- HTML
- python

ツール実行

vmdkまたはログバンドル指定し、json形式のファイルを作成し、簡易的なwebサーバを立ち上げることでCID、parentCIDのステータスを可視化できます。

[事前準備]

  1. 仮想マシンに2つのハードディスクを設定

  2. スナップショットを作成

[ツール実行手順]

  1. 仮想マシンのvmdkファイルのダウンロードまたはログバンドルを生成

  2. ツール実行の端末からアクセス可能なディレクトリにダウンロードファイルを配置

  3. 以下コマンドでjsonファイルを生成
    python3 parse_vmdk.py <vmdkファイルパス> -o vmdk_graph.json

* htmlファイルでvmdk_graph.jsonを直接指定している為変更しないでください。

  1. webサーバ立ち上げ
    python3 -m http.server 8000

  2. ブラウザにてアクセスします

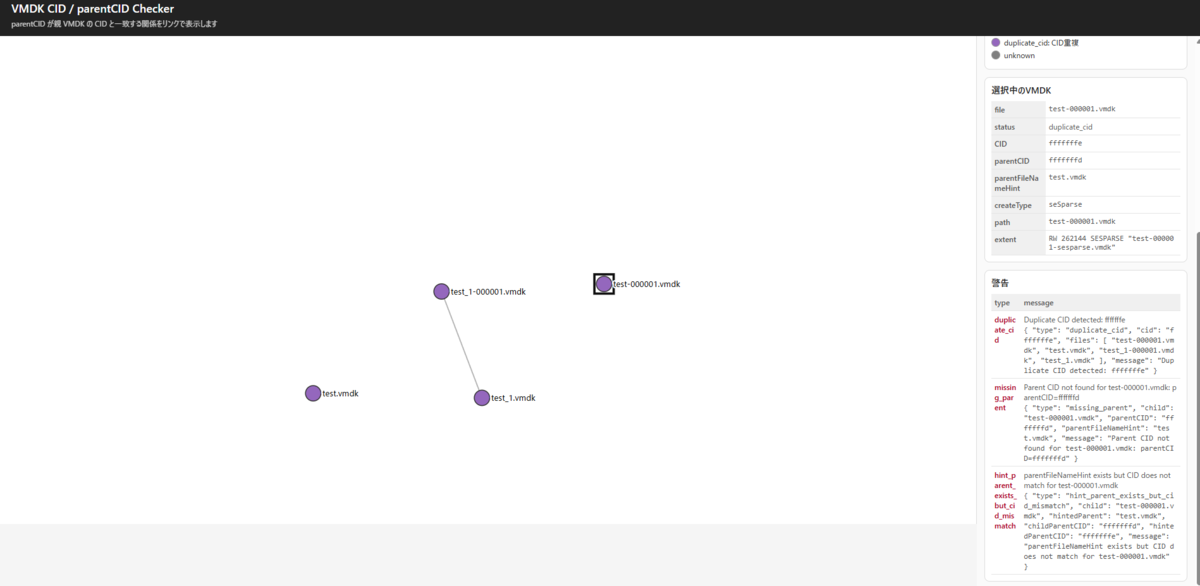
関係に問題が生じたvmdkはリンクされません。 そして警告にあるように問題のあるparentCIDが表示されます。
* 上記検証は参考例であるため、各々の環境に応じて設定してください。

作成したプログラム

Githubで公開しております。

GitHub - Hir0Lab/vmdk-cid-checker · GitHub

・parse_vmdk_bundle.py : d3.jsで取り扱えるようにjson形式に変換
・index.html : d3.jsを利用してjsonファイルを読み込み、可視化を実現

概要として以下で幾つかピックアップして説明します。

parse_vmdk_bundle.py
main()

引数としてログバンドル、vmdkファイルが格納されているディレクトリ、vmdkファイルとして指定が可能です。
それぞれの指定方法に合わせて[INFO]情報の出力を変えており、 build_graphにvmdkのデータを渡してjsonファイルを生成しています。

jsonファイル生成に必要なデータはbuild_graphの関数で作成しています。

def main() -> int:
    parser = argparse.ArgumentParser(description="Parse VMDK CID/parentCID information and generate D3 graph JSON.")
    parser.add_argument("input", help="Single .vmdk descriptor, support bundle archive, or extracted directory")
    parser.add_argument("-o", "--output", default="vmdk_graph.json", help="Output JSON file")
    args = parser.parse_args()

    input_path = Path(args.input).expanduser().resolve()
    output_path = Path(args.output).expanduser().resolve()

    if not input_path.exists():
        print(f"[ERROR] input not found: {input_path}")
        return 1

    with tempfile.TemporaryDirectory(prefix="vmdk_bundle_") as tmp:
        tmpdir = Path(tmp)

        if input_path.is_dir():
            print(f"[INFO] scanning directory: {input_path}")
            vmdks = collect_vmdks(input_path)
        elif input_path.is_file() and input_path.suffix.lower() == ".vmdk":
            print(f"[INFO] scanning single VMDK descriptor: {input_path}")
            vmdks = collect_single_vmdk(input_path)
        else:
            print(f"[INFO] extracting archive: {input_path}")
            root = extract_archive(input_path, tmpdir)
            print(f"[INFO] scanning extracted archive: {root}")
            vmdks = collect_vmdks(root)

        print(f"[INFO] VMDK descriptors found: {len(vmdks)}")

        graph = build_graph(vmdks)
        output_path.write_text(json.dumps(graph, indent=2, ensure_ascii=False), encoding="utf-8")

        print(f"[INFO] output: {output_path}")
        print("[INFO] summary:")
        for k, v in graph["summary"].items():
            print(f"  - {k}: {v}")

        if graph["warnings"]:
            print("[WARN] warnings detected. Open index.html and check warning table.")

    return 0
build_graph()

main()のjson.dumpsでjsonファイルを生成している。 本関数ではjsonファイルの生成に必要な元データを生成する。

def build_graph(vmdks: List[Dict]) -> Dict:
    nodes = []
    links = []
    warnings = []

    cid_to_nodes: Dict[str, List[Dict]] = {}
    for v in vmdks:
        if v.get("cid"):
            cid_to_nodes.setdefault(v["cid"], []).append(v)

    for cid, same_cid_nodes in cid_to_nodes.items():
        if len(same_cid_nodes) > 1:
            warnings.append({
                "type": "duplicate_cid",
                "cid": cid,
                "files": [n["path"] for n in same_cid_nodes],
                "message": f"Duplicate CID detected: {cid}"
            })

    for v in vmdks:
        status = "normal"
        if v.get("parentCID") == "ffffffff":
            status = "base"
        elif not v.get("parentCID"):
            status = "unknown"
        elif v["parentCID"] not in cid_to_nodes:
            status = "missing_parent"

        if v.get("cid") and len(cid_to_nodes.get(v["cid"], [])) > 1:
            status = "duplicate_cid"

        nodes.append({
            **v,
            "status": status,
            "label": v["file"],
        })

    node_ids = {n["id"] for n in nodes}

    for child in vmdks:
        pcid = child.get("parentCID")

        if not pcid or pcid == "ffffffff":
            continue

        candidates = cid_to_nodes.get(pcid, [])
        if not candidates:
            warnings.append({
                "type": "missing_parent",
                "child": child["path"],
                "parentCID": pcid,
                "parentFileNameHint": child.get("parentFileNameHint"),
                "message": f"Parent CID not found for {child['path']}: parentCID={pcid}"
            })
            continue

        parent = choose_parent_candidate(child, candidates)

        if parent["id"] not in node_ids or child["id"] not in node_ids:
            continue

        links.append({
            "source": parent["id"],
            "target": child["id"],
            "type": "cid_parentcid",
            "parentCID": pcid,
            "label": f"{child['file']}.parentCID = {parent['file']}.CID"
        })

    hint_index: Dict[Tuple[str, str], List[Dict]] = {}
    for v in vmdks:
        hint_index.setdefault((v["dir"], v["file"]), []).append(v)

    for child in vmdks:
        if child.get("parentCID") in (None, "ffffffff"):
            continue
        if child.get("parentCID") in cid_to_nodes:
            continue
        hint = child.get("parentFileNameHint")
        if not hint:
            continue

        hint_name = os.path.basename(hint)
        key = (child["dir"], hint_name)
        hinted = hint_index.get(key, [])
        if hinted:
            warnings.append({
                "type": "hint_parent_exists_but_cid_mismatch",
                "child": child["path"],
                "hintedParent": hinted[0]["path"],
                "childParentCID": child.get("parentCID"),
                "hintedParentCID": hinted[0].get("cid"),
                "message": f"parentFileNameHint exists but CID does not match for {child['path']}"
            })

    return {
        "nodes": nodes,
        "links": links,
        "warnings": warnings,
        "summary": {
            "vmdkDescriptors": len(nodes),
            "links": len(links),
            "warnings": len(warnings),
            "baseDisks": len([n for n in nodes if n["status"] == "base"]),
            "missingParents": len([n for n in nodes if n["status"] == "missing_parent"]),
            "duplicateCidNodes": len([n for n in nodes if n["status"] == "duplicate_cid"]),
        }
    }
index.html
d3.json

生成したvmdk_graph.jsonを読み込んだ後に実行される処理について説明します。 jsonファイルから読み込んだデータを基に、ノードとリンクを描写するコードとなります。

d3.json("vmdk_graph.json").then(data => {
  const nodes = data.nodes || [];
  const links = data.links || [];
  renderSummary(data.summary);
  renderWarnings(data.warnings);

  const link = g.append("g").attr("stroke-linecap", "round").selectAll("line").data(links).join("line").attr("class", "link");
  const node = g.append("g").selectAll("g").data(nodes).join("g").attr("class", "node").call(drag());
  node.append("circle").attr("r", radius).attr("fill", d => color(d.status));
  node.append("text").attr("x", 12).attr("y", 4).text(d => d.file);

  node.on("mouseover", (event, d) => {
      tooltip.style("display", "block").text(`${d.file}
status: ${d.status}
CID: ${d.cid}
parentCID: ${d.parentCID}
parentFileNameHint: ${d.parentFileNameHint || "-"}
path: ${d.path}`);
    })
    .on("mousemove", (event) => tooltip.style("left", `${event.clientX + 12}px`).style("top", `${event.clientY + 12}px`))
    .on("mouseout", () => tooltip.style("display", "none"))
    .on("click", (event, d) => {
      node.selectAll("circle").classed("selected", false);
      d3.select(event.currentTarget).select("circle").classed("selected", true);
      renderDetails(d);
    });

  const simulation = d3.forceSimulation(nodes)
    .force("link", d3.forceLink(links).id(d => d.id).distance(140).strength(0.85))
    .force("charge", d3.forceManyBody().strength(-550))
    .force("center", d3.forceCenter(width / 2, height / 2))
    .force("collision", d3.forceCollide().radius(d => radius(d) + 30))
    .force("x", d3.forceX(width / 2).strength(0.03))
    .force("y", d3.forceY(height / 2).strength(0.03))
    .on("tick", () => {
      link.attr("x1", d => d.source.x).attr("y1", d => d.source.y).attr("x2", d => d.target.x).attr("y2", d => d.target.y);
      node.attr("transform", d => `translate(${d.x},${d.y})`);
    });

  function drag() {
    return d3.drag()
      .on("start", (event, d) => { if (!event.active) simulation.alphaTarget(0.3).restart(); d.fx = d.x; d.fy = d.y; })
      .on("drag", (event, d) => { d.fx = event.x; d.fy = event.y; })
      .on("end", (event) => { if (!event.active) simulation.alphaTarget(0); });
  }

  document.getElementById("search").addEventListener("input", (e) => {
    const q = e.target.value.trim().toLowerCase();
    node.style("opacity", d => {
      if (!q) return 1;
      const haystack = [d.file, d.path, d.cid, d.parentCID, d.parentFileNameHint, d.status].join(" ").toLowerCase();
      return haystack.includes(q) ? 1 : 0.15;
    });
    link.style("opacity", d => {
      if (!q) return 0.75;
      const s = d.source, t = d.target;
      const haystack = [s.file, s.path, s.cid, s.parentCID, t.file, t.path, t.cid, t.parentCID].join(" ").toLowerCase();
      return haystack.includes(q) ? 0.9 : 0.1;
    });
  });
}).catch(err => {
  document.getElementById("summary").innerHTML = `
    <div class="warning">vmdk_graph.json を読み込めませんでした。</div>
    <p>同じディレクトリで HTTP サーバを起動してください。</p>
    <pre>python3 -m http.server 8000</pre>
    <p>その後、ブラウザで http://localhost:8000/ を開きます。</p>
    <pre>${htmlEscape(err)}</pre>`;
});

まとめ

本ツールはvmdkが多くCID 、 parentCIDの関係を可視化、チェックを実施したい方向けとなります。 コード修正の余地はまだまだあります。
ご参考程度にご確認ください。
VCF OperationsのvCenter linkingが失敗した際のログを覗いてみた

■はじめに

免責事項:本投稿は私個人の知見に基づいております。
所属する会社・組織とは一切関係がございません。

この投稿は、vExperts Advent Calendar 2025 の 22日目です。

普段 VCF Operations を触る機会が少ないため、本投稿では vCenter Linking のログを探索します。
トラブルシューティングも兼ねて、vCenter Linking の設定が失敗した際に、サポートバンドルからエラー原因を特定する方法を自分なりに模索した内容となっています。

■目次

■対象者

本ブログの対象者は以下です。
・VCF Operationsのログ解析に興味がある方

■環境

今回利用する環境は以下です。

・HOL(HOL-2610-01-VCF-L)

vCenter Linking の検証であるため、操作対象は以下のコンポーネントとなります。

・vCenter : vc-mgmt-a.site-a.vcf.lab, vc-wld01-a.site-a.vcf.lab
・VCF Operations : ops-a.site-a.vcf.lab

■今回の検証

トラブルシューティングをするため、事前にvCenterに細工をしました。
そのため、vCenter Linkingを設定した際にステータスがErrorとなります。

それでは、vCenter Linking の設定からトラブルシューティングを進めていきます。

■vCenter Linking設定

まずはvCenter Linkingを設定します。

  1. 以下手順に従って設定画面に移動
    Infrastructure Operations > Configurations

  2. Create GroupでGroup名を入力してNEXT

  3. vCenter Instanceを選択してNEXT

  4. 作成内容を確認してFINISH

  5. ステータスがエラーとなることを確認

■サポートバンドルダウンロード手順

次はサポートバンドルを作成しダウンロードします。

  1. 以下手順に従ってサポートバンドルの画面に移動
    Administration > Control Panel > Support Bundles

  2. ADDを押下

  3. Full Support bundleを選択

  4. サポートバンドルが作成できたらダウンロード

■エラー原因の解析

これより、ダウンロードしたログバンドルよりログ解析を行います。
先ず、ダウンロードしたログバンドルがzipファイルとなっている為、unzipコマンドで展開します。

展開すると2つのzipファイルが確認できます。
・ops-a.site-a.vcf.lab.zip
・cluster_info.zip

vCenter Linkingのエラーを特定

ops-a.site-a.vcf.lab.zipを展開することでvCenter Linkingのログファイルが確認できます。   vCenter Linkingのログはlogs/vrops-vcenter-linking.log で確認できます。

とりあえず、errorというワードでgrepしたところ、vCenter Linkingのエラー理由がログに出力されております。
一部のvCenterでサービスがunavailableになっているため、もう片方のvCenterでpeerの利用ができない状態になっているようです。

今回は2つのvCenterがある。
どっちのvCenterでサービスがunavailableになっているか特定する必要があります。

余談:全てのvCenterにログインしてサービスの状態を見に行けば・・・?というコメントはおやめください。
折角なので、vCenter IDから対象のvCenterを特定してみましょう。

それでは気を取り直して・・・

vCenter IDとvCenter Instance UUIDの関連付け

エラー出力にあるvCenter IDからvCenterのinstance UUIDを特定します。

UUIDを確認するためのログは複数ありますが、本ブログではvar/log/httpd/access_logで確認します。

赤枠が対象のInstance UUIDとなります。
このUUIDと関連があるvCenterのサービスがunavailableになっていると予想できます。

vCenter Instance UUIDとvCenter FQDNの関連付け

次に UUID から vCenter の FQDN を特定します。 logs/analytics.audit-*.logを確認することでuuidとvCenterのFQDNの両方が出力されております。

赤枠よりvCenter(vc-wld01-a.site-a.vcf.lab)でサービスがunavailableになっていると予想できます。

■ vCenterの状態確認

では実際にvCenter(vc-wld01-a.site-a.vcf.lab)を覗いてみます。

  1. vCenterにSSH接続
  2. 以下コマンドでUUIDを確認


vc-mgmt-a.site-a.vcf.lab

access_logで確認したUUIDと一致したため、間違いないようです。

次にサービス状態を確認します。
どうやら vpxd が stop 状態となっているようです。

■サービス起動とvCenter linkingをリセット
  1. vpxdのサービスを起動します。

  2. vCenter Linkingをリセットします。

Active状態となりました。

■さいごに

さいごに所感となります。
複数の製品が関係してくるとログの調査が難しいことが分かりました。
今回だとvCenter Linkingのログで対象のvCenterを見つけることが出来ず、ほかのログを探索するということが良い学びとなりました。
今後もログ解析に役立つ情報を投稿していければと思います。

Terraform CloudでAvi Load BalancerのAlert設定を自動化してみた

■はじめに

この投稿は、vExperts Advent Calendar 2024 の 13日目です。

今回はAvi Load BalancerのAlert設定周りのTerraformのテンプレートファイルを作成して
Terraform Cloudにてワークスペースを実行しAlert設定を自動化したブログになります

Terraform Cloudのより詳細な使い方は過去の検証ブログを参考に

hiro1325.hatenablog.com

■目次

■対象者

・Terraform Cloudで自動化を初めようと思っている人

・VMware Avi Load Balancerの自動化に興味がある人

■前提知識

・gitの操作が出来る

■構成図

Terraform Cloud実行における構成図は以下

■Avi Load BalancerのAlert設定

本セクションではEvent発生から通知までの仕組みに加え
実際の設定画面を使って新規でAlert設定する手順を説明

Event発生から通知

Event発生し通知されるまでのフローは以下

Alert設定概要

新規でAlert設定する場合は
手戻りを無くすためNotifications→Alert Action→Alert Configの順で設定するのが良い

今回は設定を自動化する為
Web UIの画面においては必要箇所のみ簡単に説明

Notifications(Syslog)

Syslogの設定は名前とIPアドレスのみの設定で完了
ポート番号はデフォルトで指定されている

Alert Action

Alert Actionの設定はNotificationsで作成したSyslog設定を指定

Alert Config

Alert Configの名前を指定

次にAlert Configが動作する為のトリガーになるEventを指定

最後に作成したAlert Actionを指定

参考
VMware by BroadcomのAvi Load Balancer Alert設定のドキュメント

■テンプレートファイルの準備

TerraformのAviのプロバイダーは以下を参考にしてください

registry.terraform.io

作成したテンプレートファイルは以下

provider.tf
main.tf

プロバイダー情報やAviコントローラーのユーザ情報などが記載されている
テンプレートファイル(provider.tf)は以下

terraform {
  required_providers {
    avi = {
      source = "vmware/avi"
      version = "30.2.1"
    }
  }
}
provider "avi" {
avi_username = "admin"
avi_tenant = "admin"
avi_password = "<パスワード>"
avi_controller = "< AviコントローラーのIPアドレス >"
avi_version = "30.2.1"
}

resourceブロックのリソースタイプとAviの設定項目の紐づけは以下

リソースタイプ Avi Load Balancerの設定
avi_alertsyslogconfig Notification Syslog
avi_actiongroupconfig Alert Action
avi_alertconfig Alert Config

よって作成したmain.tfは以下

data "avi_tenant" "default_tenant" {
  name= "admin"
 }

resource "avi_alertsyslogconfig" "syslog" {
  name      = "avi-syslog"
  syslog_servers {
    syslog_server = "< SyslogサーバのIP >"
    syslog_server_port = "514"
    udp = "True"
  }
  tenant_ref = data.avi_tenant.default_tenant.id
}

resource "avi_actiongroupconfig" "action" {
  name = "avi-syslog-action"
  external_only = "True"
  level = "ALERT_LOW"
  syslog_config_ref = avi_alertsyslogconfig.syslog.id
  tenant_ref = data.avi_tenant.default_tenant.id
}

resource "avi_alertconfig" "alert" {
  action_group_ref = avi_actiongroupconfig.action.id
  name = "avi-Syslog-Config-Events"
  alert_rule {
    sys_event_rule {
      event_id = "USER_LOGIN"
      not_cond = "False"
    }
  }
  category = "REALTIME"
  source = "EVENT_LOGS"
  summary = "Syslog for Config Events occured"
  throttle = "0"
}

最後にgithubにpushすればファイル作成は終了

■terrform cloudの設定

ワークスペースの作成

前回と同じリポジトリを使用するが
Avi Load Balancer用のディレクトリを作成

特定のディレクトリを指定する方法は以下の
Terraform Working Directoryにてパスを入力

その他の設定は冒頭で説明した過去の検証ブログを参考に

ワークスペースの実行

ワークスペースを実行し
terraform planが正常終了

作成されるリソースを確認
問題なければconfirm & apply

terraform applyが成功

■syslog通知の確認

Avi Load Balancerでsyslog設定が出来ているかテストメッセージを送信して確認

まずはじめにValidate settingをクリック

送信するメッセージを入力してSubmitをクリック

syslogサーバにて以下のメッセージ確認が出来る

■お片付け

最後に作成した環境のお片付けを行う terraform destoroyをTerraform Cloudで実行する手順にあたる

ワークスペースの Settings->Destruction and Deletionにて Queue destroy planをクリック

確認の為のワークスペース名が求められるので入力しQueue destroy planをクリック

terraform planが正常終了

confirm & applyをクリック

成功してsyslog設定が削除されたことが分かる

■おわりに

はじめてのアドベントカレンダーに挑戦し無事ブログを公開できたことを嬉しく思います

本ブログの内容を少しアレンジしたデモを次のJapan VMUG vExpert が語る #42で行いたいと思います

LTの動画はこちら

youtu.be

はじめてのTerraform Cloudで仮想マシンを作ってみた

■はじめに

Terraform Cloudを使い自宅ESXi環境にVM 2台をデプロイしたブログ

本ブログは過去に実施したTerraformでVMwareの自動化にチャレンジした内容を
使い方を含めTerraform Cloudでやってみた内容となっている

hiro1325.hatenablog.com

■目次

■対象者

・Terraform Cloudで自動化を初めようと思っている人

・VMware周りの自動化に興味がある人

■前提知識

・gitの操作が出来る

・vSphereの基礎的な知識がある

・dockerの基礎的な知識がある

■構成図

Terraform Cloud実行における構成図は以下

■terrform cloudの設定

ワークスペースの作成

プロジェクトの選択としてDefault Projectを選択

ワークスペースの作成

githubと連携したいので
Version Control Workflowを選択

github.comを選択

次にリポジトリを選択

ワークスペース名を入力して作成

作成されていることをワークスペースの画面より確認

terrform cloud agentの設定

terraform cloud agentを使用には terraform cloudでtokenを発行

作成済みのOrganization nameを選択 setting->Agentsにてagent poolを作成

pool名を入力して次へ

Descriptionを入力してtoken作成

次の工程の環境変数とdockerコンテナ起動で使用するので 出力された以下コマンドや変数をメモして終了 ※-dオプションが無いことに注意

■ terraform cloud agent用VMの設定

・agent用のVM(Ubuntu)を準備 事前のインストールパッケージ

apt install docker

環境変数にtokenやagent名を設定しておく

export TFC_AGENT_TOKEN=<生成されたtoken>
export TFC_AGENT_NAME=<エージェント名>

次にterraform cloud agentのコンテナを起動
terraform cloudでtoken発行した際に出力されたdockerコマンドを入力

docker run -d -e TFC_AGENT_TOKEN -e TFC_AGENT_NAME hashicorp/tfc-agent:latest

※私の場合はバックグラウンドで実行させてたいので-dオプションを付けて実行

以前のブログで検証したterraformのファイルをgithubにpush

■ ワークスペースの実行

・ワークスペースの実行には「New Run」をクリック

次に実行するRun nameを入力

terraform planが正常に終了
confirm&applyをクリック

必要に応じてコメントを入力
confirm planを実行
※コメントは必須ではありません

成功したこと確認

vCenterのタスクの開始時刻からもApplyの時刻と同じことから
正常に作成されたことを確認

■お片付け

最後に作成した環境のお片付けを行う terraform destoroyをTerraform Cloudで実行する手順にあたる

ワークスペースの Settings->Destruction and Deletionにて Queue destroy planをクリック

確認の為のワークスペース名が求められるので入力しQueue destroy planをクリック

作成時と同様に destoroyのterraform plan正常終了したので
confirm & applyをクリック

同様にコメントを入力して confirm planをクリック

成功してVMが削除されたことが分かる

同様にvCenterからも確認

■まとめ

今回は前回terraformのコマンドのみで実施した検証をTerraform Cloudで同じことをやってみた
次はAvi Load Balancerに対して実施予定

初めてのAvi Load BalancerでBGP Peeringをやって見た-③

■はじめに

第2部の続きでBGP Peeringの設定編になります
Avi Load BalancerのSEまで構築済み
下記ブログを参考にしてください

hiro1325.hatenablog.com

hiro1325.hatenablog.com

■目次

※本ブログは初心者向けに作られており且つ設定で躓いた点も含まれているため、AviのBGP設定においてはCLIだけで設定を進める内容にはなっていません
その為GUIにて設定した続きをCLIで実施するような形をとっているので、Avi ControllerについてはGUIの設定から読み進めることを推奨

■対象者

・VMware Avi Load Balancerを初めて挑戦しようと思っている人

・VMware製品に興味があるひと

■BGP形成手順

第1部の検証構成の概要図からの抜粋になるが
仮想ルーターとAvi SE間でBGP Peeringを形成

※改めて仮想ルーターはCisco CSR1000vを使用

CSR1000vのConfig

CSR100vのBGPの設定は次の通り

 
(config)#router bgp Local-ASN 
(config-router)#neighbor Peer-IP remote-as remote-ASN
 

Avi ControllerにてBGPの設定(GUI)

Avi ControllerにてBGPを設定するには
VRF Context画面にてCloudを選択します

デフォルトではGlobalが設定されてます こちらを使っていくのでチェックを付けて編集ボタンを押下

VRF Contextの編集画面に切り替わったことを確認
この画面にてBGP Peeringを有効化にします
そしてLocal ASNを入力
iBGPまたはeBGPを選択します

※timerの設定はデフォルトでkeepalive intervalとhold timeが設定されている為そのままにします

次にpeerの設定をします Addを押下

BGP Peerを形成するネットワークを選択
PrefixとPeer IPを指定

今回はpeerにVIPの広告のみを行う為
次の図のようにチェック入れて保存

Avi controller のGUIからの設定だと以上になります ここでお気づきだろうと思うが・・・ リモートASの設定は・・・?

GUIを手探りで色々と探ってみたがリモートASの設定が見当たらない

そこでここから先はCLIに切り替えて設定を見ていく

※改めてCLIで全て設定可能と思われるが、初心者向け且つ私が躓いた点としてブログにしたかった為
今回はGUIとCLIの両方を使い分けて設定していく

Avi ControllerにてBGPの設定(CLI)

ここではGUIの画面で確認がとれなかったリモートASについてのみになります

VRF Contextの設定確認

設定変更の前に現環境のVRF Context情報を確認します 複数のCloudで同じVRF Contextの名前を使っている場合はどのオブジェクトか選択が求められます

$ Avi Controllerにssh
$ shell
$ ユーザIDとパスワード入力
> show vrfcontext VRF-Context-name
> cloudを選択

検証環境で確認すると次のようになります
peers indexで指定されている番号は次のremote-asの変更する際に必要になります

remote-asの変更
> configure vrfcontext VRF Context name
> bgp_profile
> peers index index番号
> remote_as ASN
> save

※peers indexのみだと新規Peer情報作成になってしまうので既存Peer

BGP形成の確認

Avi Controllerにて確認は稼働中のPrimary SEにてBGP Peeringの画面に状態を確認します アイコンが緑になっていればEstablishedで正常にBGP Peerになっている

仮想ルーターにてBGP Peerの状態確認コマンドはこちら

#show ip bgp summary

検証環境で確認するとこちら

BGPにてVIPが広告されているか確認するコマンドはこちら

#show ip route bgp

検証環境で確認するとこちら

ここまでで仮想ルータにてBGP Peerが形成されており
VIPのアドレスを学習できていることが言えます

デモ

実際のロードバランスするの様子はJapan VMUGの活動として
2024/08/21に開催されたvExpertが語る会でデモを含めたLTにて実演してます
よそしければ参考にお願いします

※デモのみ確認したい人は09:22から見て頂ければよいかと

www.youtube.com

参考にした記事

参考にした記事はこちら

docs.vmware.com

avinetworks.com

■まとめ

Avi Load BalancerのコンポーネントからBGPを形成するまで
3部構成に渡ってブログにしてきました

恐らく、CLIで設定していくのが良いのかなと思い
更に自動化していくのがよいのかなと思った為今後は
terraformで自動化に挑戦する予定


初めてのAvi Load BalancerでBGP Peeringをやってみた-②

■はじめに

第1部の続きでAvi ControllerにてSEのデプロイの記事になります

下記記事でそれぞれのコンポーネントについて説明している為
そちらも併せて参考にしてください

hiro1325.hatenablog.com

※実際の画面を使った説明では構築済みになっている状態で説明させていただきます

■目次

■対象者

・VMware Avi Load Balancerを初めて挑戦しようと思っている人

・VMware製品に興味があるひと

■サービスエンジン構築概要

Avi Load Balancerにおいてサービスエンジン(SE)構築の流れは次の通りである

  1. Infrastructureにてcloudの設定
  2. InfrastructureのCloud ResourceにてNetworksとService Engine Groupの設定
  3. Applicationsにてpoolsの設定
  4. VS VIPの設定
  5. Virtual Serviceの設定

Virtual Serviceまで実施できると自動的にサービスエンジン(SE)のVMがデプロイされる

次から実際の操作に従って設定を行っていく

■サービスエンジン構築手順

Cloud設定

Infrastructureのcloudにてcreateボタンを押下しプルダウンメニューから
VMware vCenter/vSphere ESXを選択する

cloudの名前は任意に設定してvCenter/vSphereの設定箇所に
SEをデプロイする対象のvCenter情報を入力する

Pools設定

Poolsの設定で必要な項目は以下になる

・Pools名
・Poolsに紐づけるCloud
・ロードバランスのアルゴリズム
・ロードバランスさせるサーバの登録

まずはじめにApplications PoolsにてCreate Poolを押下

Poolsの設定画面が開くので任意のPools名を付けていただきCloudの情報を紐づけます

Cloudを紐づけると次のようになる

次にロードバランスのアルゴリズムを選択します
今回はラウンドロビンにします

次にロードバランスさせるサーバを登録します
IPアドレスかDNS名にて登録が可能

Poolsの設定はここまでとする

VIP設定

次にApplications VS VIPにてVIPを作成

VIPの作成画面が開くので他と同様に任意の名前を設定
そしてCloudを紐づけます

次にVIPを設定するためにAddを押下

今回の検証ではIPv4で行っていくためVIPとして設定するアドレスを入力してAdd

このVIPで使うアドレスはどのネットワークかを選択

ここまで設定できたらSAVEしてVIPの設定終わりです

VS設定

次に仮想サービス(VS)の作成を行います

ApplicationsのVirtual Servicesにてcreate Virtual ServiceにてAdvanced setupを押下します

Cloudの選択画面にて今回作成したCloudを選択します

VSの名前と作成したVIPを選択

作成したpoolsを選択

サービスエンジンの確認

VSまで作成ができたらサービスエンジンが自動的にデプロイされる

デプロイされたVMは次の画面にて確認が出来る

まとめ

第2部のブログではAvi Controllerの設定にてサービスエンジン(SE)がデプロイできるとこまで実施
各コンポーネントが何をやっているか設定しながら抑えていく必要がある
次はBGP設定に取り掛かる